一条通知里的取件码:toCode 的混合识别引擎
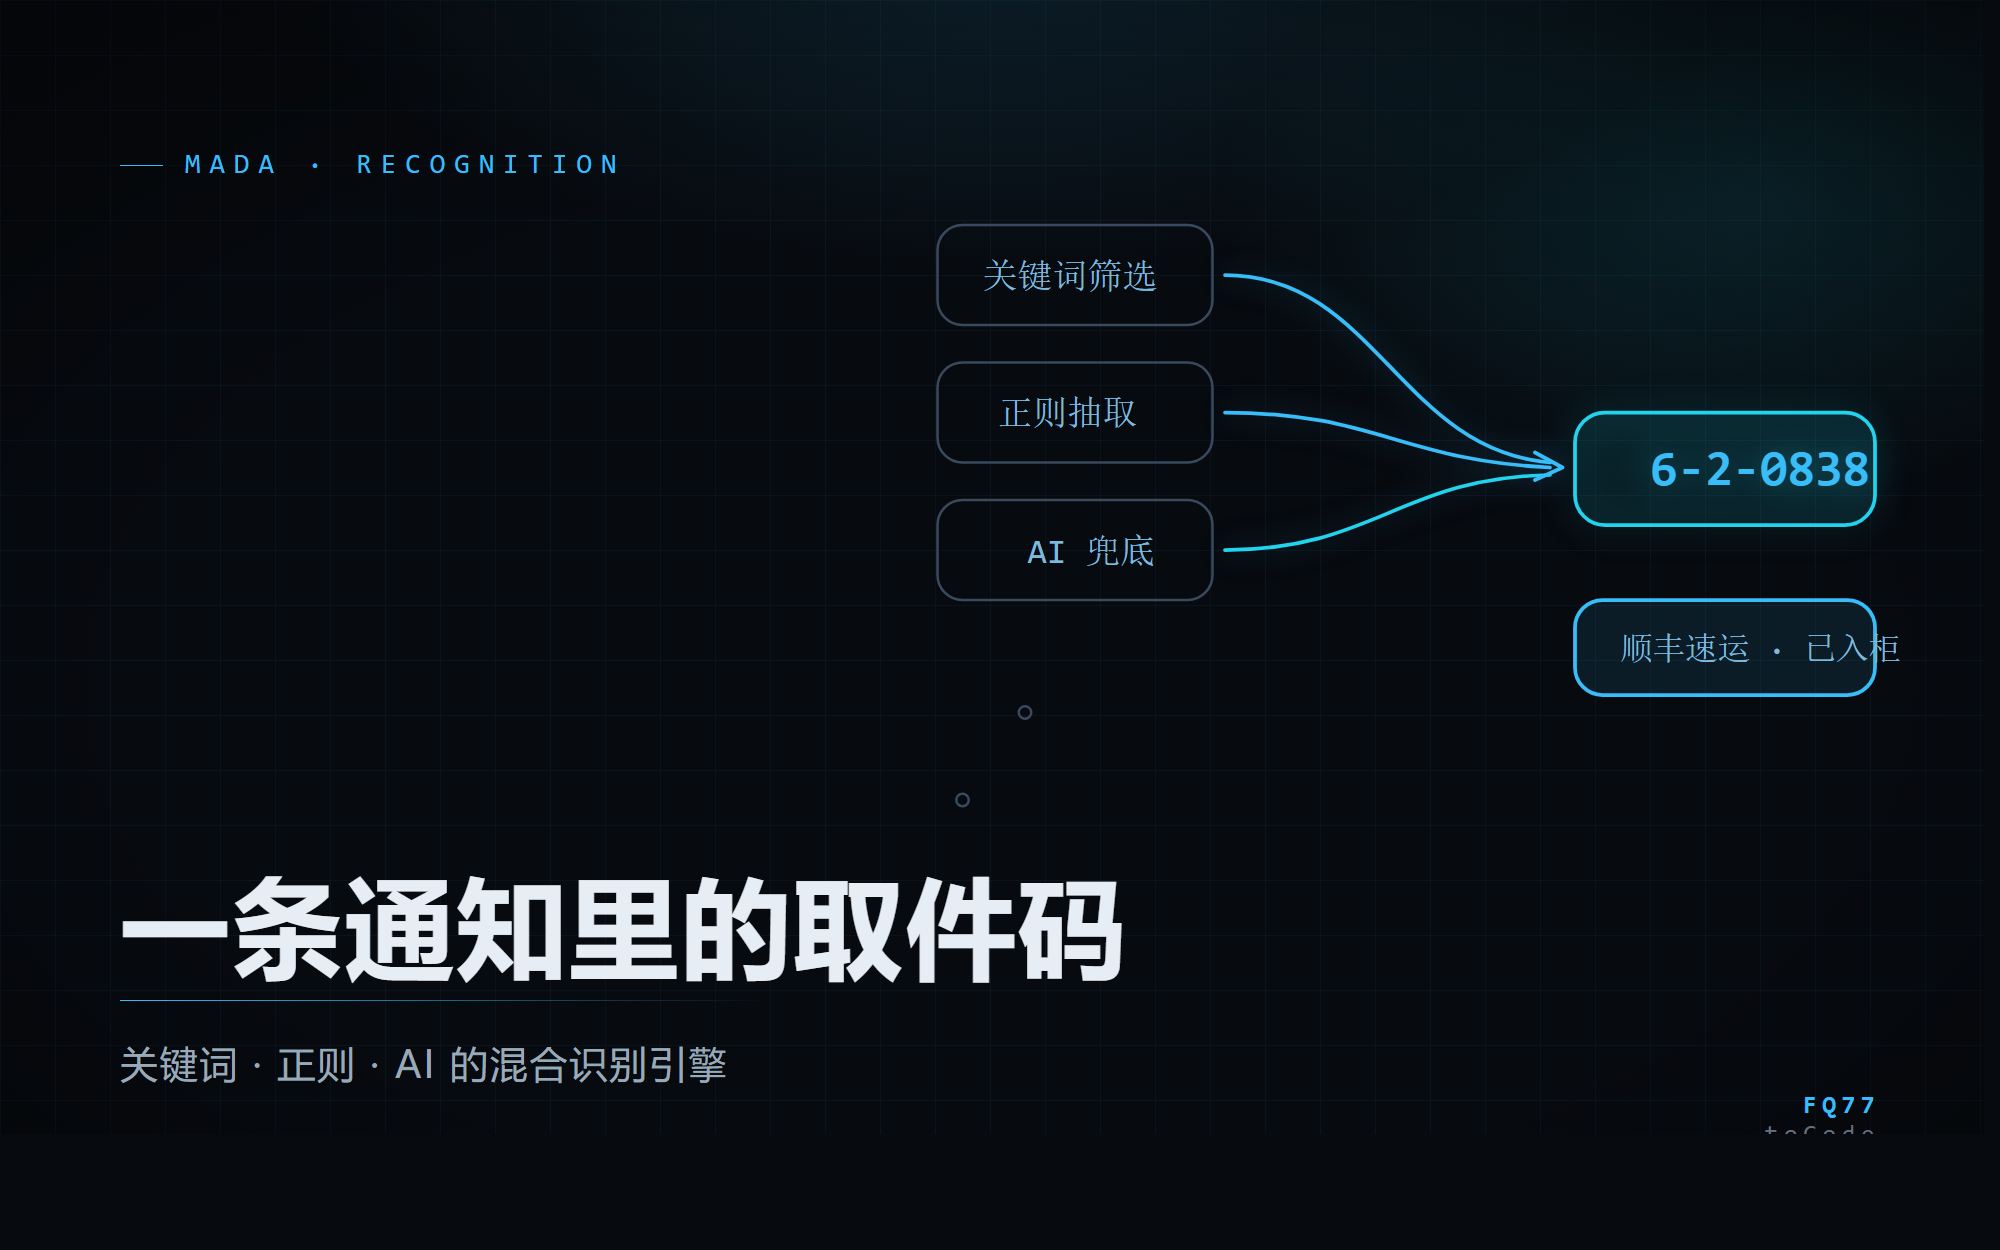
从中文快递通知里抽取取件码的难点是排除运单号、日期、金额与门牌号。toCode 用关键词初筛 + 三级正则(前缀词/分段数字/纯数字兜底)+ AI 兜底组成流水线,误报代价高于漏报。
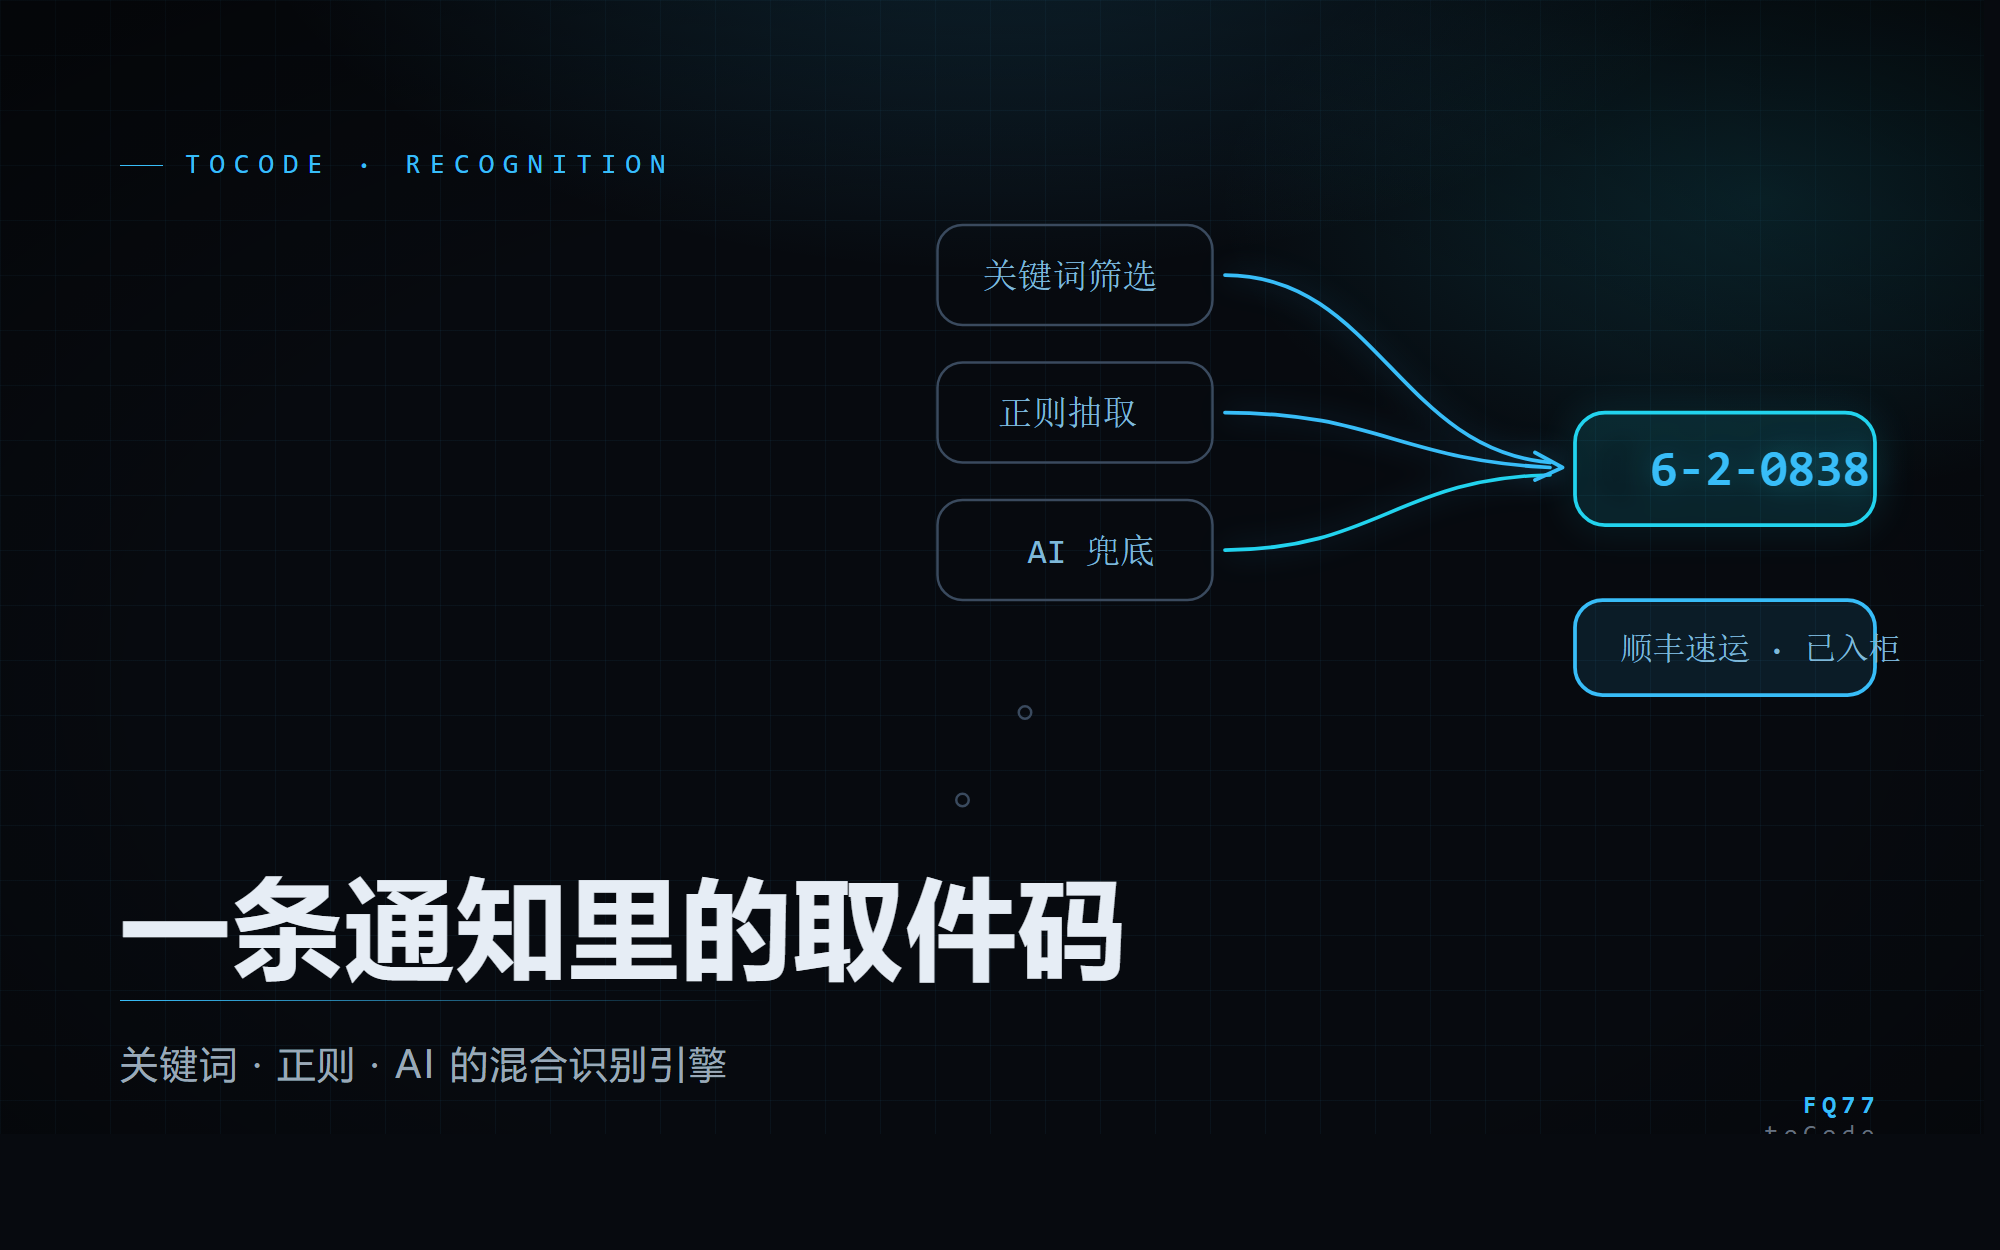
「码达 toCode」系列第二篇:一条中文快递通知如何被拆成「取件码 + 快递公司 + 地点」三个结构化字段——关键词初筛、三级正则抽取、AI 兜底与防误判设计。
难点在哪
取件码抽取看起来是"从文本里抠个数字",真正的难点是排除干扰。一条典型的通知长这样:
【顺丰速运】您的快递已到菜鸟驿站(12栋广场东侧),请凭取件码 6-2-0838 前往取件。快递柜超时将退回,运单号 SF1234567890,费用 0 元。
里面同时存在:取件码 6-2-0838、运单号 SF1234567890、金额 0 元、门牌号 12栋、短信签名 【顺丰速运】。任何一步贪婪匹配都可能抓错。码达的解法是把识别拆成四级流水线,每一级只做一件事、只放行该放行的:
flowchart TD
    A["通知标题 + 正文"] --> B{"KeywordMatcher<br/>40+ 快递关键词命中?"}
    B -- 否 --> Z["丢弃"]
    B -- 是 --> C{"AI 开关开启?"}
    C -- 是 --> D["AiRecognizer 语义抽取"]
    D -- 成功 --> W["入库"]
    D -- 失败/关闭 --> E
    C -- 否 --> E["CodeExtractor 正则抽取"]
    E --> E1{"① 前缀词正则<br/>取件码/提货码/凭码…"}
    E1 -- 命中 --> W
    E1 -- 未命中 --> E2{"② 分段数字<br/>6-2-0838(排除日期/金额)"}
    E2 -- 命中 --> W
    E2 -- 未命中,允许兜底 --> E3{"③ 纯数字<br/>唯一最长者"}
    E3 -- 命中 --> W
    E3 -- 未命中 --> Z
第一级:关键词初筛
KeywordMatcher 内置 40+ 关键词,按语义分了五类:快递实体(快递/包裹/运单/物流)、取件动作(取件/请取件/已放入)、场所(驿站/代收点/自提柜/丰巢/兔喜/妈妈驿站)、社区团购(多多买菜/美团优选)、状态语(已到站/已入柜/请尽快领取)。用户可以在设置里追加自定义关键词(逗号分隔),覆盖小众驿站的通知措辞。
这一级是廉价过滤器:90% 的无关通知(微信、新闻、营销)在这里就被 contains 拒掉了,后面昂贵的正则和 AI 请求根本不会发生。
第二级:三级取件码抽取
CodeExtractor.extract() 是整个项目打磨最久的函数,三步各有讲究:
① 前缀词正则。 12 种前缀(取件码/取货码/取件号/提货码/开箱码/取件口令/凭码/提取码/取件密码/柜机码/格口码)后跟 [^0-9A-Za-z]{0,8}? 的松散分隔再捕获 2~20 位字母数字。这是最可信的模式——通知主动声明了"这就是取件码"。命中后还要过 isPlausible(至少含一个数字)并做 normalize:剥掉全角括号与引号包裹、去掉句尾标点、统一 ·/—/– 为 -。
② 分段数字。 蜂巢、菜鸟的取件码经常是 6-2-0838 这种「柜号-格口-码」结构,但日期 2026-10-21 也是分段数字!这里用三个排除规则:
val dashed = segmentedCode.findAll(text).firstOrNull {
    !dateLikeCode.matches(it.value) &&          // 不是日期
    it.value.count { c -> c.isDigit() } >= 4 && // 数字总量够
    !isAmount(text, it.range)                   // 上下文不是金额
}
isAmount() 检查命中区间前后是否有货币信号——后面跟「元/块/圆」或前面是 ¥/¥ 的一律排除。「费用 0 元」这种陷阱就此化解。
③ 纯数字兜底(可配置)。 对完全没有标记的通知,找所有 4~8 位连续数字,排除年份(19xx/20xx)与金额上下文后,如果候选者中最长者唯一就选它,否则取第一个。这个"唯一最长"的启发式基于一个观察:取件码几乎总是通知里最长的孤立数字,而运单号通常带字母前缀不会匹配 (?<!\d)\d{4,8}(?!\d)。用户也可以直接关掉兜底,宁可漏抓不可错抓。
第三级:快递公司与地点
快递公司识别(identifyCourier)有一个细节:匹配词表按长度降序排列(顺丰同城 → 顺丰速运 → 顺丰),因为"顺丰"是"顺丰同城"的前缀,不排序会吞掉短词。另外优先在短信签名 【】 里找——签名是发信方自报的品牌,比正文可靠。
地点解析(PickupLocationParser)是三级正则链:括号包裹的站点名(菜鸟驿站(...))→ 动词触发的站点("已放至/已送达/请前往" + 站点后缀词)→ 宽松匹配兜底。后缀词表覆盖驿站/快递柜/自提点/便利店等 12 类,动词表覆盖 17 种投放措辞。任何一级命中后还要剥掉开头动词、修剪冒号并校验长度 2~60。
第四级:AI 兜底
以上规则覆盖不了长尾(驿站自创话术、表情符号混排、英文通知),码达提供了可选的 AI 通道。AiRecognizer 的 System Prompt 用 300 token 预算做严格约束:
输出格式严格为:{"isExpress":true或false,"code":…,"courier":…,"location":…}
严禁把运单号、订单号、手机号、日期时间、件数、金额、快递单尾号
或地址中的数字当成取件码;不确定时输出 null,绝不猜测。
值得注意的是工程处理:AI 返回的 courier / location 为 null 时回退到本地正则的结果(ExpressRecognizer.identifyCourier / PickupLocationParser),两条通道的结果做字段级合并;AI 调用失败(网络/密钥/超时)时整条通知无缝降级为本地识别,并经 AiCallMonitor 记录失败原因供设置页展示。识别来源最终写入 recognizedBy 字段(local/ai),列表页可见。
测试
识别引擎是无状态纯函数,天然可测。项目配了 6 个单测类:CodeExtractorTest(分段码 vs 日期 vs 金额)、ExpressRecognizerTest、KeywordMatcherTest、PickupLocationParserTest、ExpressRepositoryTest(合并/恢复语义)、AiRecognizerTest(JSON 解析容错)。每修一个误判 case,先把它变成测试用例再改代码——工具类应用的可信度就是这样一条条攒出来的。
小结
码达识别引擎的设计原则:规则优先、AI 兜底、误报的代价高于漏报。正则链路把每一类干扰(日期、金额、运单号、年份)都变成显式排除规则,AI 只处理长尾且失败可降级;所有识别结果可追溯(recognizedBy)、可测试、可自定义。对一个每天在用户手机后台默默工作的工具来说,"安静地准确"比"聪明"更重要。
 已运行
 北京时间